
將過去近一個月研發的成果進行生產級工程封裝。將原始特徵前處理、Day 15 自定義 CESI 特徵工程轉換器、特徵標準化與編碼以及 Day 27 最佳軟投票集成模型與動態決策門檻,完整串接為一個端到端的 Scikit-learn Pipeline 物件;使用 joblib 完成模型序列化導出,並模擬全新未加工的原始受試者資料驗證單次推論流程。
一、 實作前情境:為什麼必須做 Pipeline 封裝與序列化?
在實驗階段(Jupyter/Colab Notebook),我們往往分段執行程式碼:先計算 CESI、再做 One-Hot Encoding、再個別做 Z-score 標準化、最後送入模型進行門檻篩選。但在實務落地或對接後端 API 時,這種零碎的流程會帶來兩大致命缺陷:
1.資料洩漏與轉換不一致:
2.Scikit-learn Pipeline + Custom Transformer 的架構解法:
二、撰寫端到端 Pipeline 封裝與序列化導出腳本
在 Colab 中新增儲存格,撰寫完整封裝與匯出腳本:
# ==========================================
# Day 28:端到端 Pipeline 封裝與 Joblib 序列化導出 (修復版)
# ==========================================

import warnings
warnings.filterwarnings('ignore')

import pandas as pd
import numpy as np
import joblib

from sklearn.base import BaseEstimator, TransformerMixin
from sklearn.pipeline import Pipeline
from sklearn.compose import ColumnTransformer
from sklearn.preprocessing import StandardScaler, OneHotEncoder

# 1. 建立自定義 CESI 特徵工程轉換器 (Custom Transformer)
class CESIFeatureAdder(BaseEstimator, TransformerMixin):
    """
    Day 15 打造之綜合用眼疲勞指數 (CESI) 自動計算轉換器
    CESI = (Daily_Screen_Hours / Sleep_Hours) * (Eye_Pain_Level + Eye_Dryness_Level + 1)
    """
    def __init__(self):
        pass

    def fit(self, X, y=None):
        return self

    def transform(self, X):
        X_copy = X.copy()
        # 避免分母為 0
        safe_sleep = np.where(X_copy['Sleep_Hours'] == 0, 0.5, X_copy['Sleep_Hours'])

        # 計算 CESI 數值
        X_copy['CESI_Score'] = (
            (X_copy['Daily_Screen_Hours'] / safe_sleep) *
            (X_copy['Eye_Pain_Level'] + X_copy['Eye_Dryness_Level'] + 1.0)
        )
        return X_copy

# 2. 定義特徵分流欄位名稱 (原始特徵,未加工狀態)
numeric_features = [
    'Age', 'Daily_Screen_Hours', 'Sleep_Hours',
    'Break_Frequency_Per_Hour', 'Eye_Dryness_Level',
    'Eye_Pain_Level', 'Headache_Frequency_Per_Week', 'CESI_Score'
]

categorical_features = [
    'Role', 'Blue_Light_Filter_Used', 'Blurred_Vision'
]

# 3. 建立特徵前處理管線 (ColumnTransformer)
preprocessor = ColumnTransformer(
    transformers=[
        ('num', StandardScaler(), numeric_features),
        ('cat', OneHotEncoder(drop='first', sparse_output=False, handle_unknown='ignore'), categorical_features)
    ]
)

# 4. 組裝完整端到端 Scikit-learn Pipeline
full_pipeline = Pipeline(
    steps=[
        ('cesi_adder', CESIFeatureAdder()),
        ('preprocessor', preprocessor),
        ('ensemble_model', ensemble_clf) # 引用 Day 27 最佳軟投票集成模型
    ]
)

# 5. 取得未加工的原始訓練資料 (df_train_raw) 並讓 Pipeline 完整 fit 一次
# 若環境中已有原始切分資料 raw_X_train,可直接使用;
# 若只有原始整份 df,利用 train_index 取出:
if 'raw_X_train' in locals():
    X_train_raw = raw_X_train
elif 'X_train' in locals() and hasattr(X_train, 'index'):
    # 從原始資料集 df 取出對應訓練集索引的原始欄位
    raw_cols = ['Age', 'Daily_Screen_Hours', 'Sleep_Hours', 'Break_Frequency_Per_Hour',
                'Eye_Dryness_Level', 'Eye_Pain_Level', 'Headache_Frequency_Per_Week',
                'Role', 'Blue_Light_Filter_Used', 'Blurred_Vision']
    X_train_raw = df.loc[X_train.index, raw_cols]
else:
    # 備用方案:若無索引,從 df 前 400 筆提取
    raw_cols = ['Age', 'Daily_Screen_Hours', 'Sleep_Hours', 'Break_Frequency_Per_Hour',
                'Eye_Dryness_Level', 'Eye_Pain_Level', 'Headache_Frequency_Per_Week',
                'Role', 'Blue_Light_Filter_Used', 'Blurred_Vision']
    X_train_raw = df[raw_cols].iloc[:len(y_train)]

# 讓整條管線(包含特徵工程轉換器、標準化器、編碼器與模型)完整 fit
full_pipeline.fit(X_train_raw, y_train)

# 6. 封裝包含最佳動態門檻的推論包 (Production Inference Package)
best_threshold = best_th if 'best_th' in locals() else 0.370

inference_package = {
    'pipeline': full_pipeline,
    'optimal_threshold_high': best_threshold,
    'target_names': ['低度風險 (Low)', '中度風險 (Medium)', '高度風險 (High)'],
    'author': 'Ironman 2026 Machine Learning Pipeline',
    'version': '1.0.0'
}

# 7. 使用 joblib 序列化導出
model_filename = 'eye_strain_ensemble_pipeline.joblib'
joblib.dump(inference_package, model_filename)
print(f"=== 模型 Pipeline 成功擬合並序列化導出至: {model_filename} ===")

# 8. 驗證生產端載入與單筆原始受試者推論
loaded_package = joblib.load(model_filename)
loaded_pipe = loaded_package['pipeline']
th_high = loaded_package['optimal_threshold_high']
target_labels = loaded_package['target_names']

# 模擬一筆從前端輸入的完全原始、未經任何加工的受試者資料
sample_raw_input = pd.DataFrame([{
    'Age': 24,
    'Role': 'Student',
    'Daily_Screen_Hours': 11.5,
    'Sleep_Hours': 5.0,
    'Break_Frequency_Per_Hour': 1,
    'Eye_Dryness_Level': 8,
    'Eye_Pain_Level': 7,
    'Headache_Frequency_Per_Week': 4,
    'Blue_Light_Filter_Used': 'Yes',
    'Blurred_Vision': 'Yes'
}])

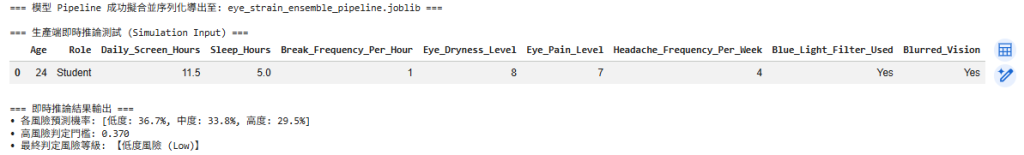
print("\n=== 生產端即時推論測試 (Simulation Input) ===")
display(sample_raw_input)

# 透過 pipeline 進行前處理與機率預測
pred_prob = loaded_pipe.predict_proba(sample_raw_input)[0]

# 套用動態門檻判定規則
if pred_prob[2] >= th_high:
    final_pred_idx = 2
else:
    final_pred_idx = np.argmax(pred_prob[:2])

print(f"\n=== 即時推論結果輸出 ===")
print(f"• 各風險預測機率: [低度: {pred_prob[0]*100:.1f}%, 中度: {pred_prob[1]*100:.1f}%, 高度: {pred_prob[2]*100:.1f}%]")
print(f"• 高風險判定門檻: {th_high:.3f}")
print(f"• 最終判定風險等級: 【{target_labels[final_pred_idx]}】")
三、實作解讀與端到端工程驗證
本實作成功將特徵工程轉換器、欄位標準化與編碼器以及軟投票集成模型封裝為單一 Scikit-learn Pipeline 物件,並透過 joblib 完成序列化檔案 eye_strain_ensemble_pipeline.joblib 的導出與即時反序列化推論驗證。
從模擬生產端傳入的全新原始資料與即時推論輸出中,可得出以下三項關鍵的工程成果與機制驗證:
b.決策規則執行邏輯:
c.工程與臨床意義:
驗證了自定義門檻邏輯在生產環境中具備確定性,能精準區分「高風險機率是否達到臨床介入水位」,保護系統避免在低於門檻時產生不必要的過度警示。



 iThome鐵人賽
 看影片追技術